Cách tạo sitemap.xml và robots.txt đúng chuẩn cho website
English
Trả lời nhanh: Để tạo s2itemap.xml và robots.txt chuẩn, bạn cần hiểu rõ mục đích của từng file. Sitemap.xml liệt kê tất cả các URL quan trọng mà bạn muốn công cụ tìm kiếm lập chỉ mục, thường được tạo tự động bằng các plugin SEO như Yoast SEO hoặc Rank Math. Robots.txt hướng dẫn bot tìm kiếm không truy cập vào các thư mục hoặc trang cụ thể, giúp quản lý quyền truy cập hiệu quả. Việc này giúp cải thiện SEO đáng kể, đặc biệt khi website có hơn 50 trang.
Với bất kỳ website nào muốn được Google tìm thấy và lập chỉ mục đầy đủ, việc tạo sitemap.xml và robots.txt đúng chuẩn cho website là bước kỹ thuật nền tảng không thể bỏ qua. Hai file này tuy nhỏ nhưng lại quyết định cách công cụ tìm kiếm "nhìn thấy" và thu thập dữ liệu trên site của bạn, ảnh hưởng trực tiếp đến tốc độ index và hiệu quả SEO tổng thể.
Nhiều chủ website, đặc biệt là người mới làm SEO, thường bỏ qua hai file này hoặc cấu hình sai khiến Googlebot bỏ lỡ những trang quan trọng, thậm chí vô tình chặn cả website khỏi kết quả tìm kiếm. Bài viết dưới đây hướng dẫn cách tạo, cấu hình và kiểm tra sitemap.xml cùng robots.txt sao cho chuẩn SEO, áp dụng được cho cả website WordPress lẫn website tự code.
Sitemap.xml là gì và vì sao website cần có?
Sitemap.xml là file dạng XML liệt kê các URL quan trọng trên website mà bạn muốn công cụ tìm kiếm thu thập dữ liệu và lập chỉ mục. Có thể hình dung sitemap như tấm bản đồ chỉ đường, giúp Googlebot không phải tự mò mẫm qua từng liên kết mà vẫn biết chính xác trang nào tồn tại, cập nhật lần cuối khi nào và mức độ ưu tiên ra sao.
Với những website có cấu trúc liên kết nội bộ phức tạp, nhiều trang nằm sâu, hoặc website mới ít được nguồn bên ngoài trỏ liên kết đến, sitemap.xml gần như bắt buộc để đảm bảo các trang này được crawl và index đúng hạn. Một số lợi ích cụ thể:
- Giúp Google phát hiện nhanh trang mới đăng, hữu ích với website tin tức, blog cập nhật thường xuyên.
- Thông báo cho công cụ tìm kiếm biết trang nào vừa chỉnh sửa để crawl lại kịp thời.
- Hỗ trợ index tốt hơn cho các trang có ít liên kết nội bộ trỏ đến.
- Cung cấp dữ liệu theo dõi tình trạng index trong Google Search Console, giúp phát hiện sớm trang bị lỗi hoặc bị loại khỏi chỉ mục.
Robots.txt là gì và vai trò trong việc kiểm soát crawl
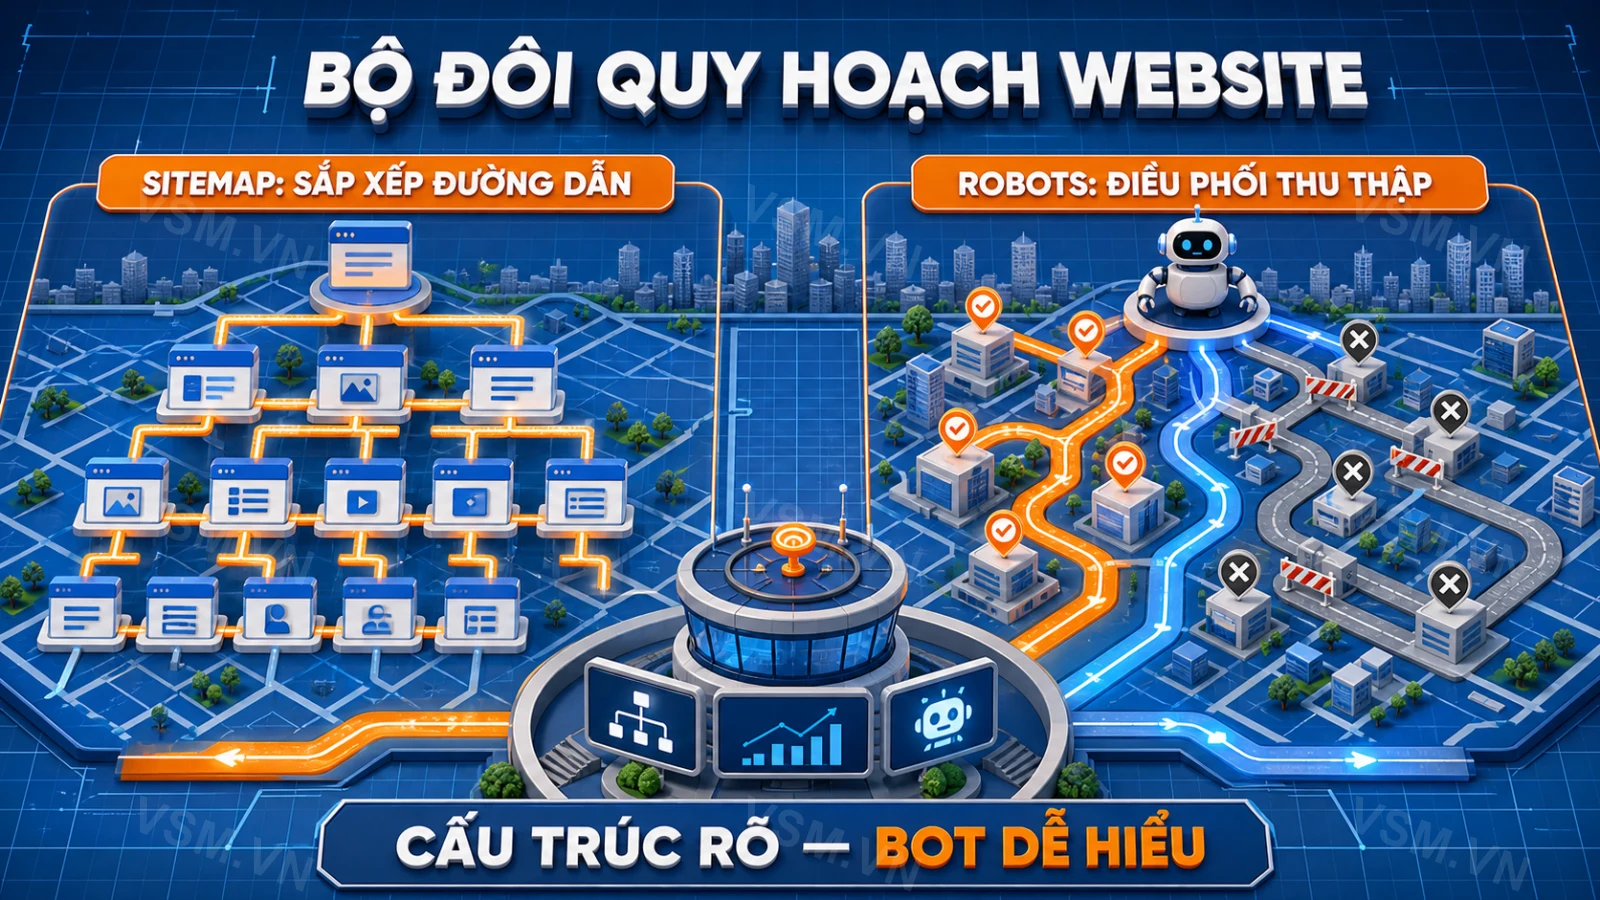
Nếu sitemap.xml là bản đồ chỉ đường thì robots.txt đóng vai trò biển báo giao thông, quy định khu vực nào bot được phép vào và khu vực nào cần tránh. Đây là file văn bản thuần đặt tại thư mục gốc của website (ví dụ: vsm.vn/robots.txt), chứa các chỉ thị hướng dẫn crawler nên hoặc không nên thu thập dữ liệu ở đường dẫn nào.
Robots.txt thường dùng để ngăn bot lãng phí "ngân sách crawl" vào những trang không cần thiết như trang quản trị, trang tìm kiếm nội bộ, giỏ hàng, file tạm hoặc trang trùng lặp nội dung. Kiểm soát tốt phần này giúp Google tập trung crawl vào những trang thực sự mang lại giá trị SEO.
Hướng dẫn tạo file sitemap.xml chuẩn SEO
Cấu trúc cơ bản của một file sitemap.xml
Một sitemap.xml chuẩn tuân theo giao thức Sitemaps mà Google, Bing và các công cụ tìm kiếm lớn cùng thống nhất. Cấu trúc tối thiểu gồm thẻ mở <urlset> khai báo namespace, bên trong là danh sách thẻ <url>, mỗi thẻ chứa đường dẫn tuyệt đối (loc), thời gian cập nhật gần nhất (lastmod), tần suất thay đổi dự kiến (changefreq) và mức ưu tiên (priority). Loc là bắt buộc, các thẻ còn lại tùy chọn nhưng nên có để cung cấp thêm tín hiệu cho bot.
Một vài lưu ý khi xây dựng nội dung sitemap:
- Chỉ đưa vào những URL chuẩn (canonical), có thể index được; tránh nhét trang bị chặn bởi thẻ noindex hoặc bị robots.txt chặn crawl vì gây mâu thuẫn tín hiệu.
- Không đưa các trang trả về mã lỗi 4xx, 5xx hoặc trang redirect vào sitemap.
- Giới hạn mỗi file tối đa 50.000 URL hoặc dung lượng 50MB; nếu vượt quá cần chia nhiều file và dùng sitemap index để gộp lại.
Cách tạo sitemap tự động cho các nền tảng phổ biến
Với WordPress, các plugin SEO như Yoast SEO, Rank Math hay All in One SEO tự động sinh sitemap.xml và cập nhật liên tục mỗi khi có bài viết mới, không cần thao tác thủ công. Với website tự code (PHP, Laravel, Node.js...), cần viết script lấy dữ liệu từ cơ sở dữ liệu rồi xuất ra đúng định dạng XML, nên đặt lịch chạy tự động (cron job) để sitemap luôn đồng bộ với nội dung thực tế. Các nền tảng thương mại điện tử thường tự sinh sẵn sitemap, quản trị viên chỉ cần kiểm tra và khai báo lại với công cụ tìm kiếm.
Sau khi tạo xong, luôn kiểm tra bằng cách truy cập trực tiếp đường dẫn dạng tenmien.vn/sitemap.xml trên trình duyệt để chắc chắn file hiển thị đúng định dạng XML, không lỗi cú pháp hay trả về trang trắng.
Hướng dẫn tạo file robots.txt đúng chuẩn
Cú pháp cơ bản
File robots.txt dùng cú pháp đơn giản, gồm các nhóm chỉ thị áp dụng cho từng loại bot (User-agent), theo sau là dòng Disallow (chặn crawl) hoặc Allow (cho phép crawl) áp dụng cho đường dẫn cụ thể. Cấu hình an toàn cho phần lớn website thường cho phép mọi User-agent truy cập toàn bộ site, chỉ chặn riêng thư mục quản trị hoặc thư mục hệ thống, đồng thời khai báo đường dẫn sitemap.xml bằng dòng Sitemap ở cuối file để công cụ tìm kiếm dễ tìm thấy ngay khi ghé thăm website lần đầu.
Những lỗi thường gặp khi cấu hình robots.txt
Đây là file rất dễ cấu hình sai và hậu quả có thể nghiêm trọng, thậm chí khiến cả website biến mất khỏi kết quả tìm kiếm. Một số lỗi cần tránh:
- Vô tình chặn toàn bộ website bằng dòng Disallow: / — lỗi thường gặp khi website chuyển từ staging sang production mà quên gỡ chỉ thị chặn.
- Chặn nhầm thư mục chứa CSS, JavaScript khiến Googlebot không render đúng giao diện, ảnh hưởng đánh giá trải nghiệm người dùng.
- Nhầm lẫn giữa chặn crawl (robots.txt) và chặn index (thẻ meta noindex) — trang bị chặn crawl vẫn có thể xuất hiện trên kết quả tìm kiếm nếu có liên kết trỏ đến, chỉ là Google không đọc được nội dung bên trong.
- Đặt sai vị trí file — robots.txt bắt buộc nằm ở thư mục gốc tên miền, đặt trong thư mục con sẽ không có tác dụng.
Khai báo với Google Search Console và so sánh hai file
Tạo xong hai file này chỉ là bước đầu, bạn cần khai báo với công cụ tìm kiếm để crawl và index diễn ra hiệu quả. Trong Google Search Console, vào mục Sitemaps, dán đường dẫn sitemap.xml rồi gửi đi; Google sẽ báo cáo số URL đã phát hiện và đã lập chỉ mục thành công. Với robots.txt, công cụ robots.txt Tester giúp xem trước một đường dẫn cụ thể có bị chặn crawl hay không trước khi áp dụng thay đổi lên môi trường thực tế.
Tuy thường nhắc đến cùng nhau, hai file phục vụ mục đích trái ngược: sitemap.xml chủ động "mời gọi" — khai báo những trang muốn được crawl và index; robots.txt "ngăn cản" — chỉ định khu vực không muốn bot ghé qua. Một website tối ưu tốt cần phối hợp cả hai: sitemap chỉ chứa trang chất lượng đáng index, robots.txt loại bỏ trang trùng lặp hoặc trang kỹ thuật không mang giá trị tìm kiếm.
Đây chỉ là một trong nhiều yếu tố kỹ thuật cấu thành chiến lược SEO hoàn chỉnh. Bên cạnh sitemap và robots.txt, các yếu tố như thẻ tiêu đề, mô tả meta, cấu trúc heading, tốc độ tải trang hay liên kết nội bộ cũng cần được xử lý đồng bộ. Nếu không có đủ thời gian hay nhân sự kỹ thuật để tự triển khai toàn diện, Dịch Vụ SEO Onpage của VSM có thể giúp rà soát và tối ưu toàn bộ các yếu tố này đúng chuẩn Google. Để có cái nhìn tổng thể hơn về những hạng mục công việc một SEOer cần đảm nhiệm, bạn có thể tham khảo thêm bài viết Tổng Quan Về SEO Tổng Thể, SEOer Cần Làm Những Gì? trước khi bắt tay triển khai.
Câu hỏi thường gặp
Website nhỏ vài chục trang có bắt buộc phải có sitemap.xml không? Không bắt buộc tuyệt đối vì Googlebot vẫn có thể tự crawl qua liên kết nội bộ, nhưng vẫn nên tạo vì chi phí gần như bằng không trong khi lợi ích về tốc độ index rất rõ ràng, đặc biệt với website mới chưa có nhiều liên kết trỏ đến.
Robots.txt có ngăn được các bot xấu, công cụ crawl dữ liệu trái phép không? Không. Robots.txt chỉ là quy ước tự nguyện, các bot uy tín như Googlebot, Bingbot sẽ tuân thủ, nhưng bot độc hại hoàn toàn có thể bỏ qua. Để chặn bot xấu thực sự, cần dùng thêm biện pháp như tường lửa ứng dụng web (WAF) hoặc giới hạn theo địa chỉ IP.
Có nên đưa toàn bộ URL của website vào sitemap.xml không? Không nên. Chỉ nên đưa vào URL chuẩn, có giá trị nội dung và mong muốn được index. Trang kết quả tìm kiếm nội bộ, trang lọc sản phẩm trùng lặp hay trang phân trang không cần thiết nên được loại khỏi sitemap để tránh làm loãng tín hiệu chất lượng.
Sau khi cập nhật robots.txt, Google cập nhật lại ngay hay cần chờ? Google thường crawl lại robots.txt khá thường xuyên (trong vòng 24 giờ), nhưng để chắc chắn thay đổi được áp dụng ngay, bạn có thể dùng công cụ robots.txt Tester trong Search Console để yêu cầu Google đọc lại file mới nhất.